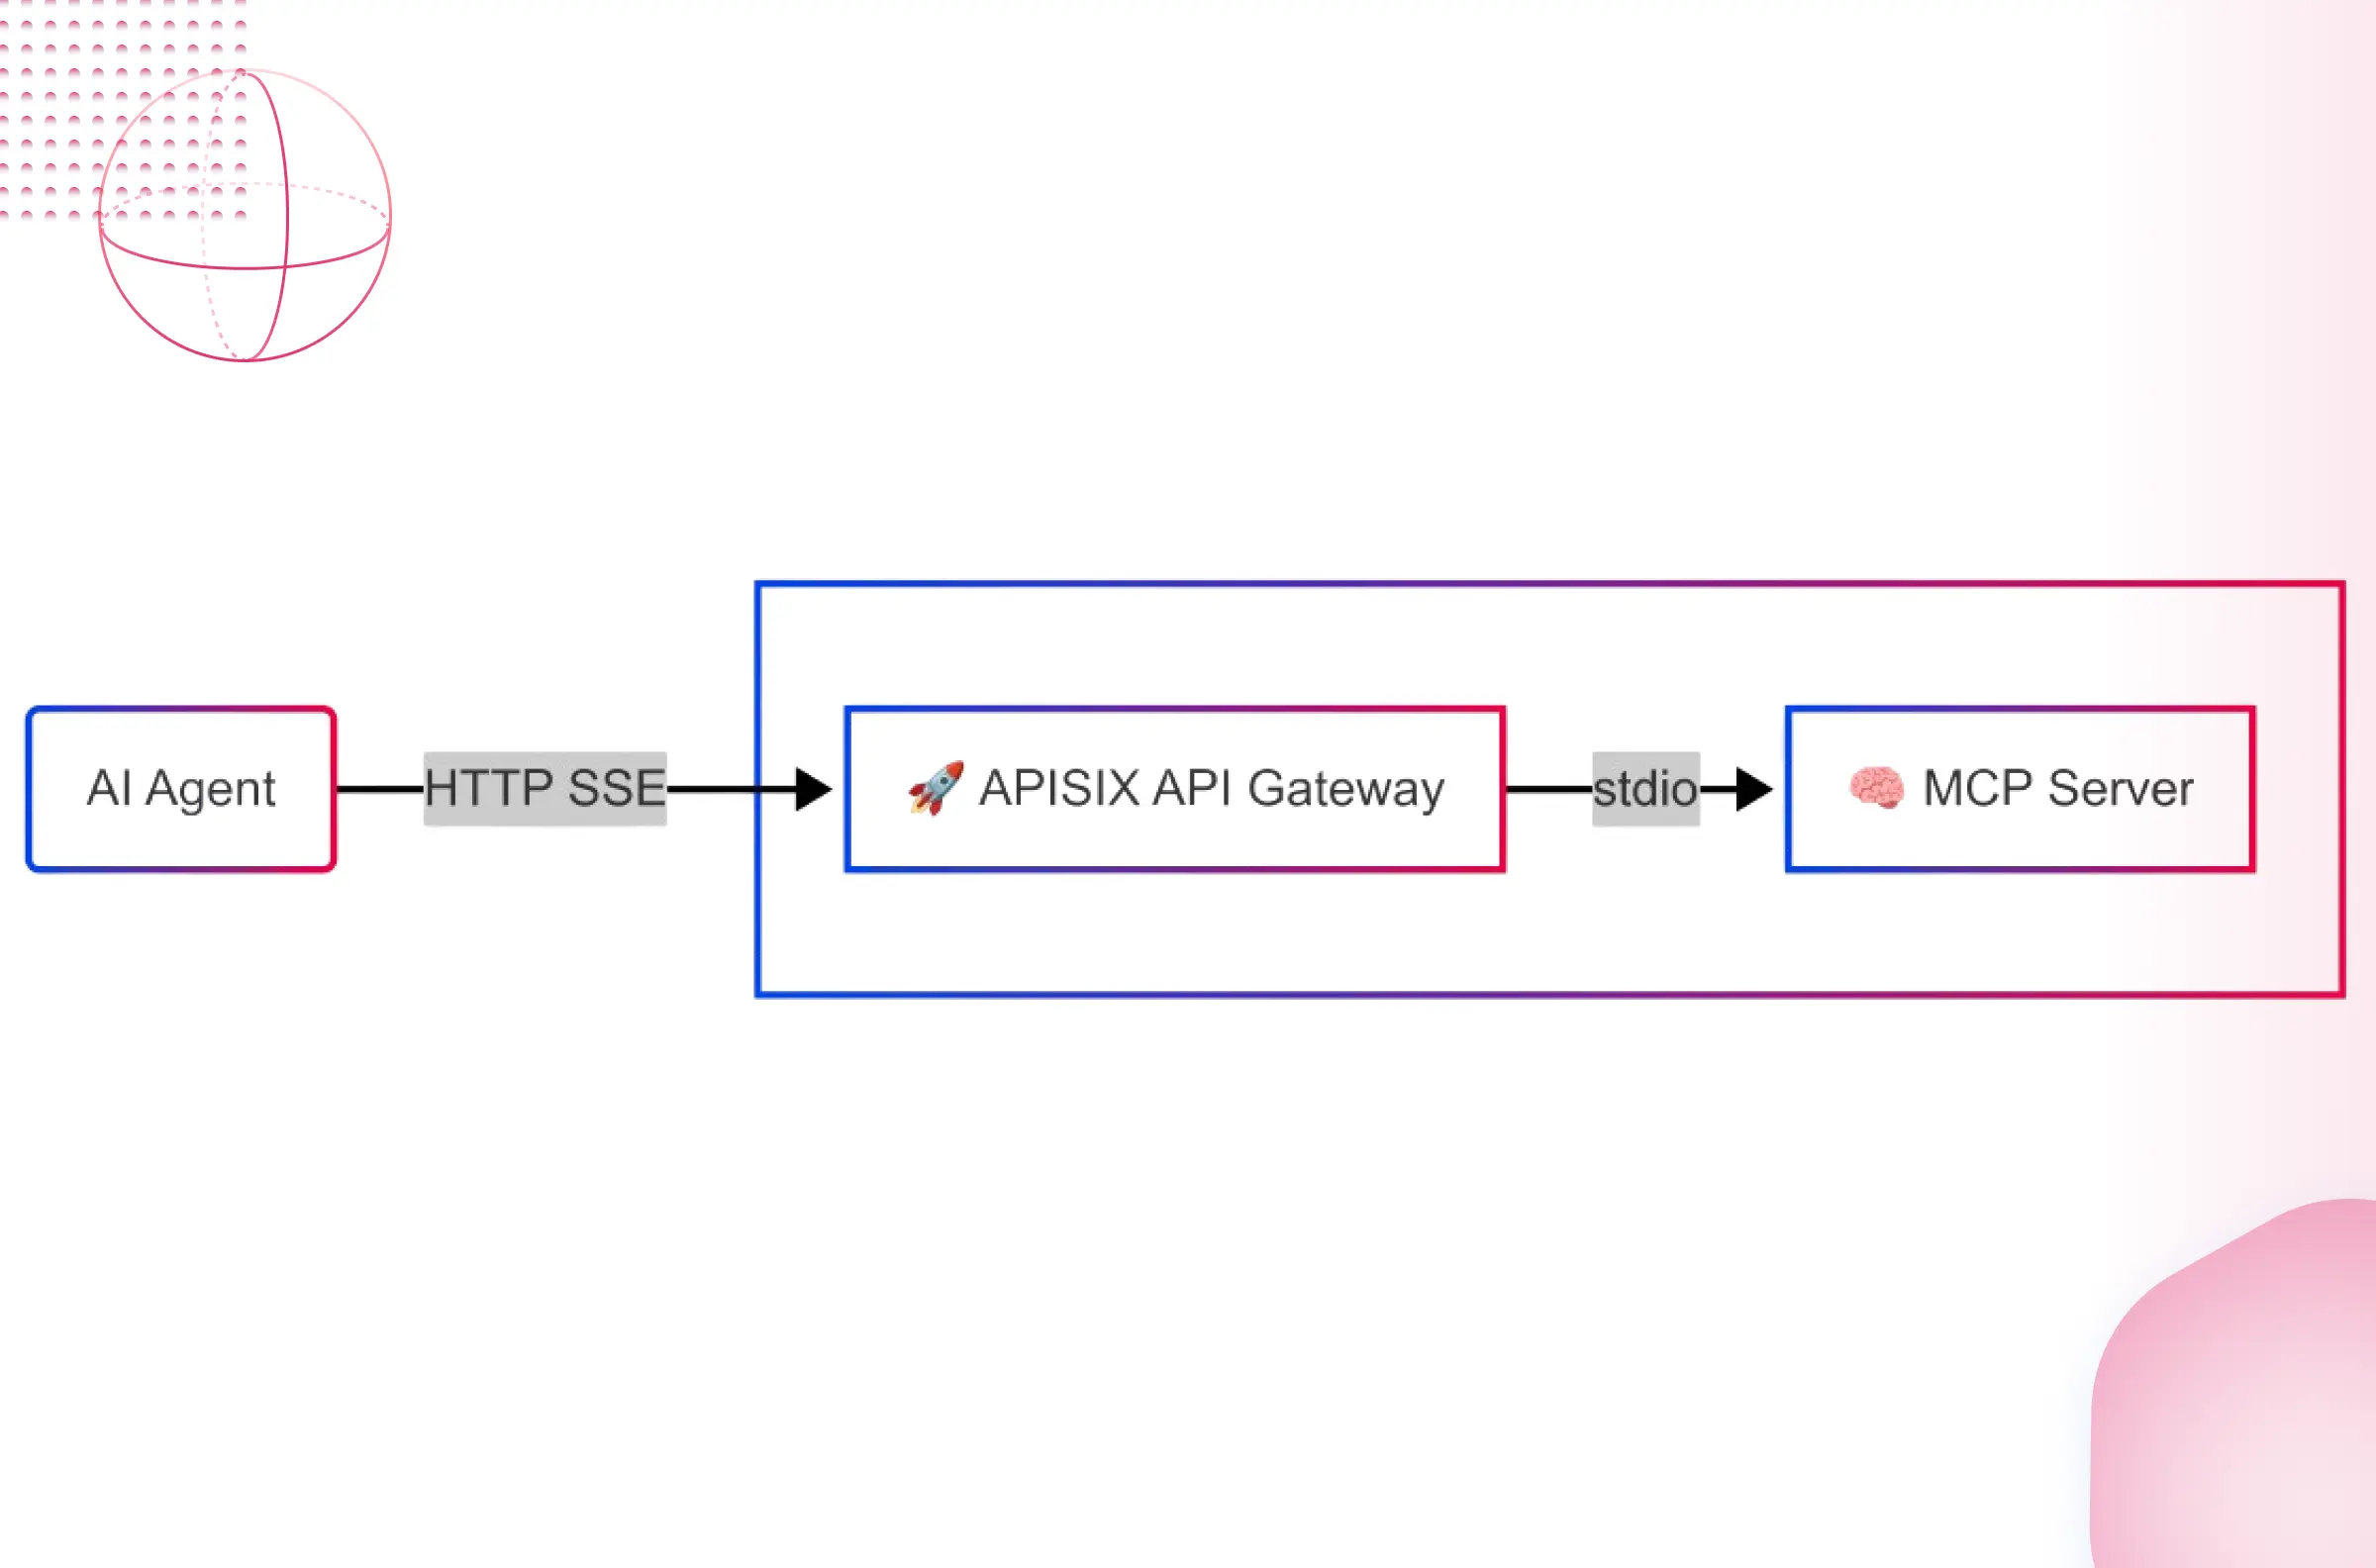
Apache APISIX AI 网关核心功能
Apache APISIX AI 网关通过开源插件为 LLM 流量提供模型代理、配置型路由、响应缓存、Token 限制、提示词控制、检索和网关层可观测能力。本文将这些能力与对应的 APISIX 插件逐一关联。
为什么 AI 流量需要额外的网关控制
LLM 请求与普通 API 流量一样,需要身份认证、路由、限流、故障处理和可观测性。同时,它还涉及供应商特定的请求格式、按 Token 计算的用量、持续时间较长的流式响应,以及提示词处理等要求。
Apache APISIX 在已授权应用和已配置模型端点之间的网络路径上处理这些问题。它不负责选择工具、编排 Agent 工作流、评估回答质量,也不能替代应用层授权。这些职责仍属于应用和 AI 平台层。
代理到受支持的模型供应商
ai-proxy 插件可将请求转发到文档列出的模型供应商和 OpenAI 兼容端点。它可以转换受支持的请求格式、从网关配置中附加供应商凭证,并向应用提供一致的访问端点。
实际兼容性取决于所选的 APISIX provider 类型和上游 API。团队应核对每个供应商的请求和响应字段,而不应假设所有模型都实现相同接口。
配置多模型路由与故障处理
ai-proxy-multi 插件在已配置的模型实例之间分配请求。其文档列出的策略包括加权轮询和一致性哈希,并可配置健康检查、有限重试和 fallback 行为。
APISIX 3.18 还支持语义路由算法。运维人员为每个实例提供示例提示词并配置 embedding 服务;插件会比较请求提示词与这些示例的相似度,选择达到阈值且最相近的实例。这是显式配置的意图路由,不是基于模型成本、延迟、回答质量或业务结果的自动优化。
语义路由不参与健康检查、重试或常规 fallback 策略。只有在没有实例达到相似度阈值或 embedding 请求失败时,才会使用其指定的 fallback。加权轮询和一致性哈希仍使用各自文档所述的故障处理选项。
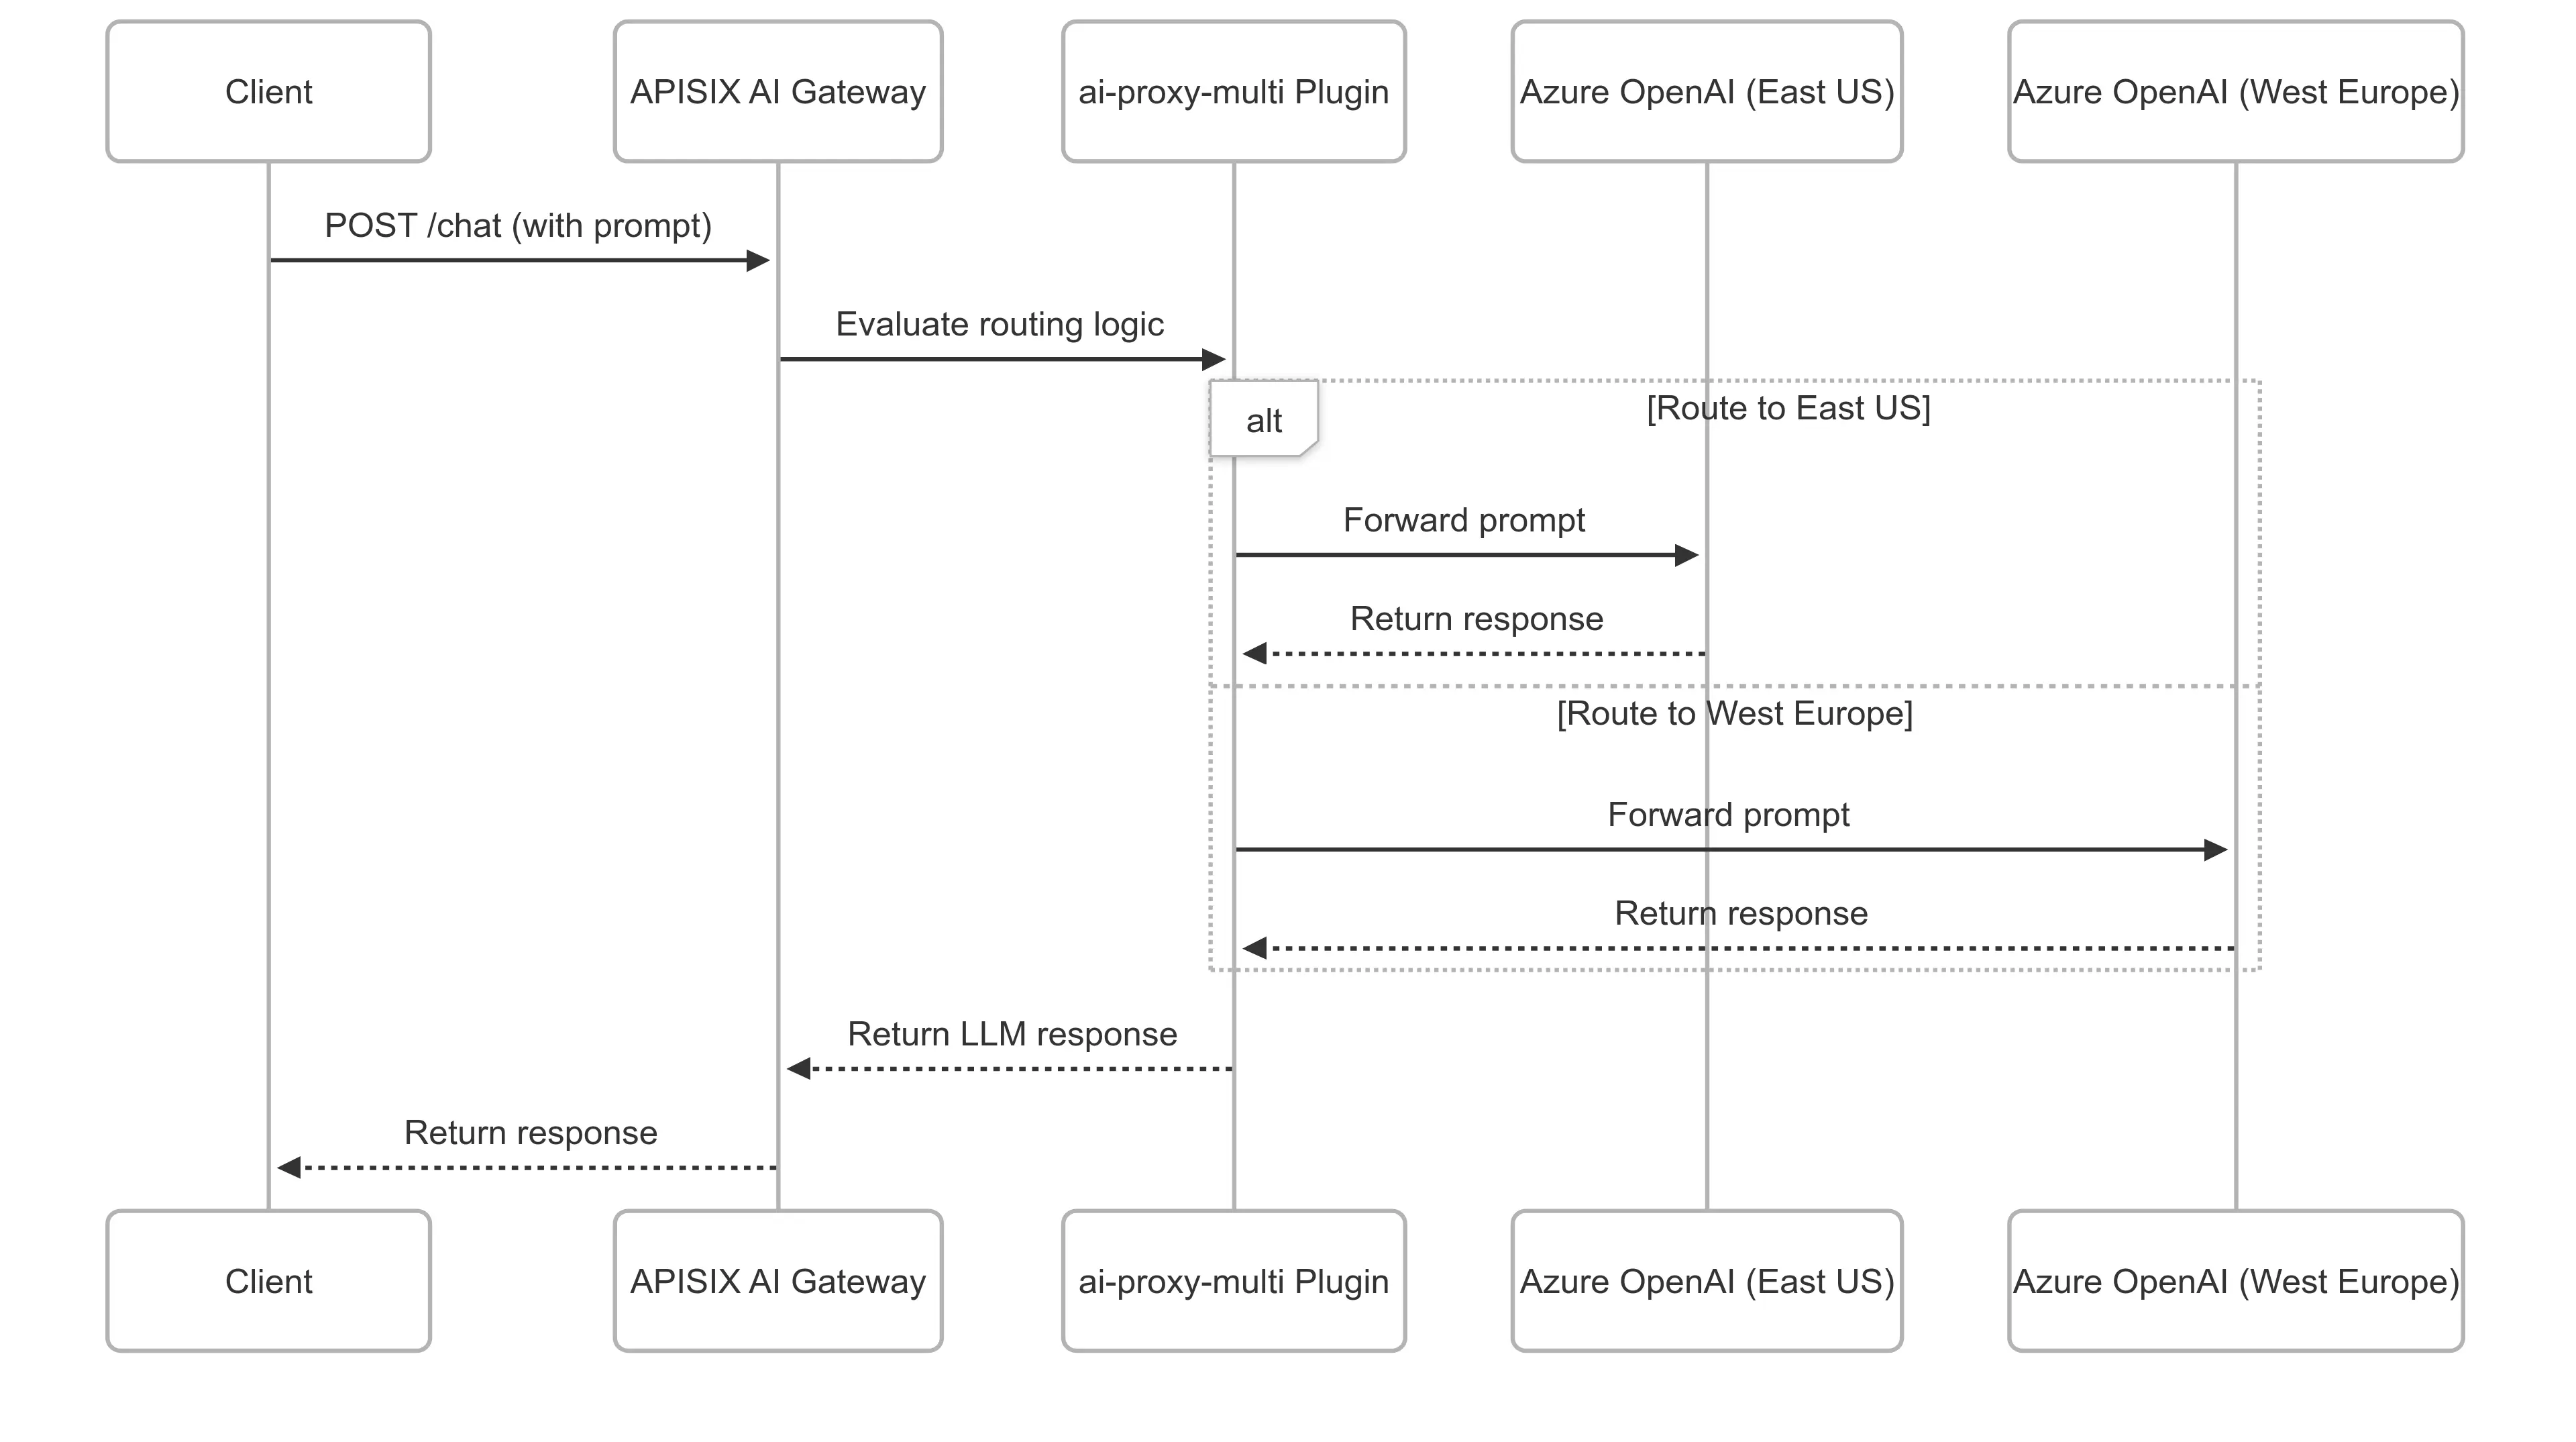
这些能力可以减少应用中的供应商特定路由逻辑,但不能保证服务永不中断。可用性仍取决于上游健康状态、网络条件、超时、重试上限和配置的 fallback 路径。
执行基于 Token 的用量限制
不同 LLM 请求消耗的输入和输出 Token 数量可能相差很大。ai-rate-limiting 插件可根据 Token 消耗而不只是请求次数执行限流。
该插件支持本地和 Redis 计数器。运维人员可以通过网关配置设定适合应用的用量边界。插件会在收到响应后记录提供商返回的用量,并在观察到的计数已耗尽额度后拒绝后续请求。因此,单个大响应或并发请求仍可能使观察到的用量超过配置限制,之后的请求才会被拒绝。模型定价、预算、账单核对和成本分摊仍需由外部系统负责。
缓存完整的 LLM 响应
ai-cache 插件与 ai-proxy 或 ai-proxy-multi 配合,将完整的 LLM 响应缓存到 Redis。精确匹配默认启用。团队也可以选择增加语义匹配,这要求 Redis 部署提供所需的 Redis Search 命令,并配置 embedding 服务。Redis 集成指南 的配套实验固定使用 Redis Open Source 8.10.1;若使用更早的 Redis Open Source 或 Redis Stack 版本,应固定并明确测试具体版本。
对于流式响应,插件只有在收到终止事件后才会写入缓存;中断的流不会被缓存,因此不会回放不完整响应。团队仍需根据应用的数据和时效要求配置缓存资格、隔离范围、过期时间、绕过规则和语义阈值。
缓存条目默认按 Route 隔离,而不是按 Consumer 隔离。在多租户 Route 上,应先认证每个租户,再启用 cache_key.include_consumer,按 Consumer 身份划分缓存。如果租户身份来自其他可信服务端来源,可通过 cache_key.include_vars 加入对应的 NGINX 变量。未经认证的流量仍会共享 Route 级缓存,除非加入可信服务端变量;仅由客户端控制的请求头不能作为租户隔离边界。
使用职责明确的提示词与内容控制
APISIX 为不同的提示词处理需求提供了独立插件:
ai-prompt-template应用预定义的提示词模板。ai-prompt-decorator在提示词前后添加配置内容。ai-prompt-guard根据配置的正则表达式允许或拒绝提示词。ai-aws-content-moderation按文档所述流程集成 Amazon Comprehend。ai-aliyun-content-moderation按文档所述流程集成阿里云内容审核服务。ai-lakera-guard集成 Lakera Guard v2 API,与ai-proxy或ai-proxy-multi配合后,可按配置检查受支持的 LLM 请求、响应或两者。
这些控制具有不同的范围和失败处理方式。模式匹配和供应商特定的内容审核无法保证内容绝对安全或符合所有合规要求。团队仍需实施应用授权、数据分类、密钥管理、供应商治理,并在必要时安排人工审核。
添加文档支持的 RAG 检索步骤
ai-rag 插件实现了当前文档中基于 Azure OpenAI Embeddings 和 Azure AI Search 的检索流程。它会检索相关上下文,并将其加入受支持的模型请求。
该能力可以为兼容部署集中处理文档所述的检索步骤,但它不是适用于所有知识库的通用连接器,也不能评估事实准确性或消除模型幻觉。
在网关层观察 AI 流量
启用 AI 代理日志后,如果上游响应提供相应信息,APISIX 可以记录模型、请求耗时、输入和输出 Token 数量,以及首个 Token 返回时间。现有日志和可观测性插件可以将这些网关数据导出到团队的监控系统。
网关遥测只覆盖经过 APISIX 的请求。它补充而非替代应用链路追踪、供应商侧监控、用户反馈和模型质量评估。
使用同一网关管理 API 与 AI 流量
Apache APISIX 可以将现有的路由、身份认证、流量管理和可观测能力与 AI 专用插件结合使用。当这种架构符合团队需求时,可以通过同一个开源网关管理 API 和已配置的模型流量。
其价值来自明确且可审查的策略,而不是自动决策。团队需要配置 APISIX 使用的供应商、路由、缓存策略、限制、提示词控制、检索服务和可观测性集成。
总结
Apache APISIX 通过职责明确的插件增加 AI 流量控制,包括供应商代理、配置型多模型与语义路由、响应缓存、有限重试与 fallback、Token 限制、提示词处理、外部内容审核集成、文档支持的 Azure RAG 流程和网关层遥测。
这些能力应在各自的文档边界内使用。APISIX 管理到模型服务的流量;业务授权、Agent 编排、工作流状态、模型评估和合规决策仍由外围应用系统负责。